|
I am a Research Scientist at Sharpa Robotics. I have previously worked for NetEase AI Lab, Tencent Robotics X, Huawei (Autonomous Driving) and Shanghai Qi Zhi Institute. My work lies in machine learning, computer vision and robotics. In particular, my research focuses on solving (1) high cost for training data in robotic domain, (2) high cost for policy learning in the real-world, and (3) high cost for model evaluation in the real-world. |
|
|
Representative papers are highlighted. Acceptance builds resume, while rejection makes man. |
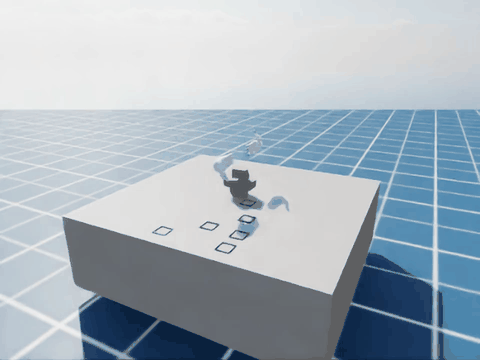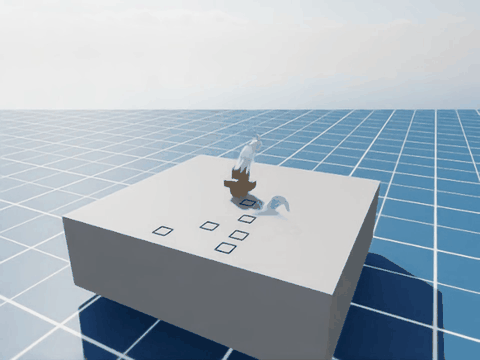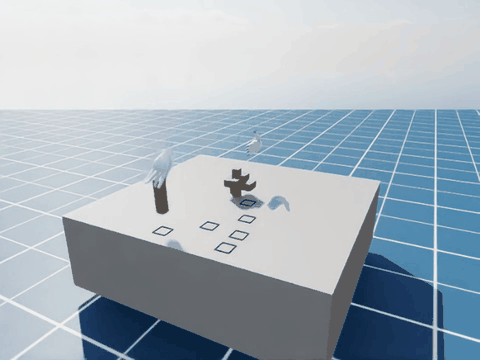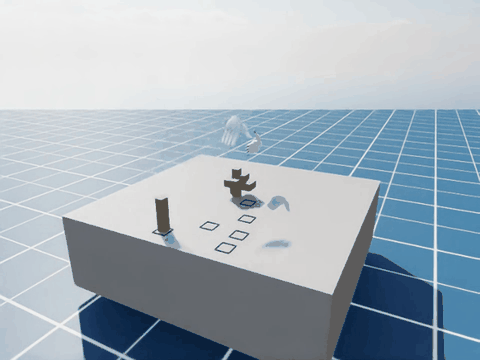 |
Feng Chen*, Pei Zhou*, Lixuan He*, Yunchao Yao*, Li Sun*, Shenghua Gao, Mingyu Ding, Kaifeng Zhang, Kaichen Zhou, Yi Ma arXiv |
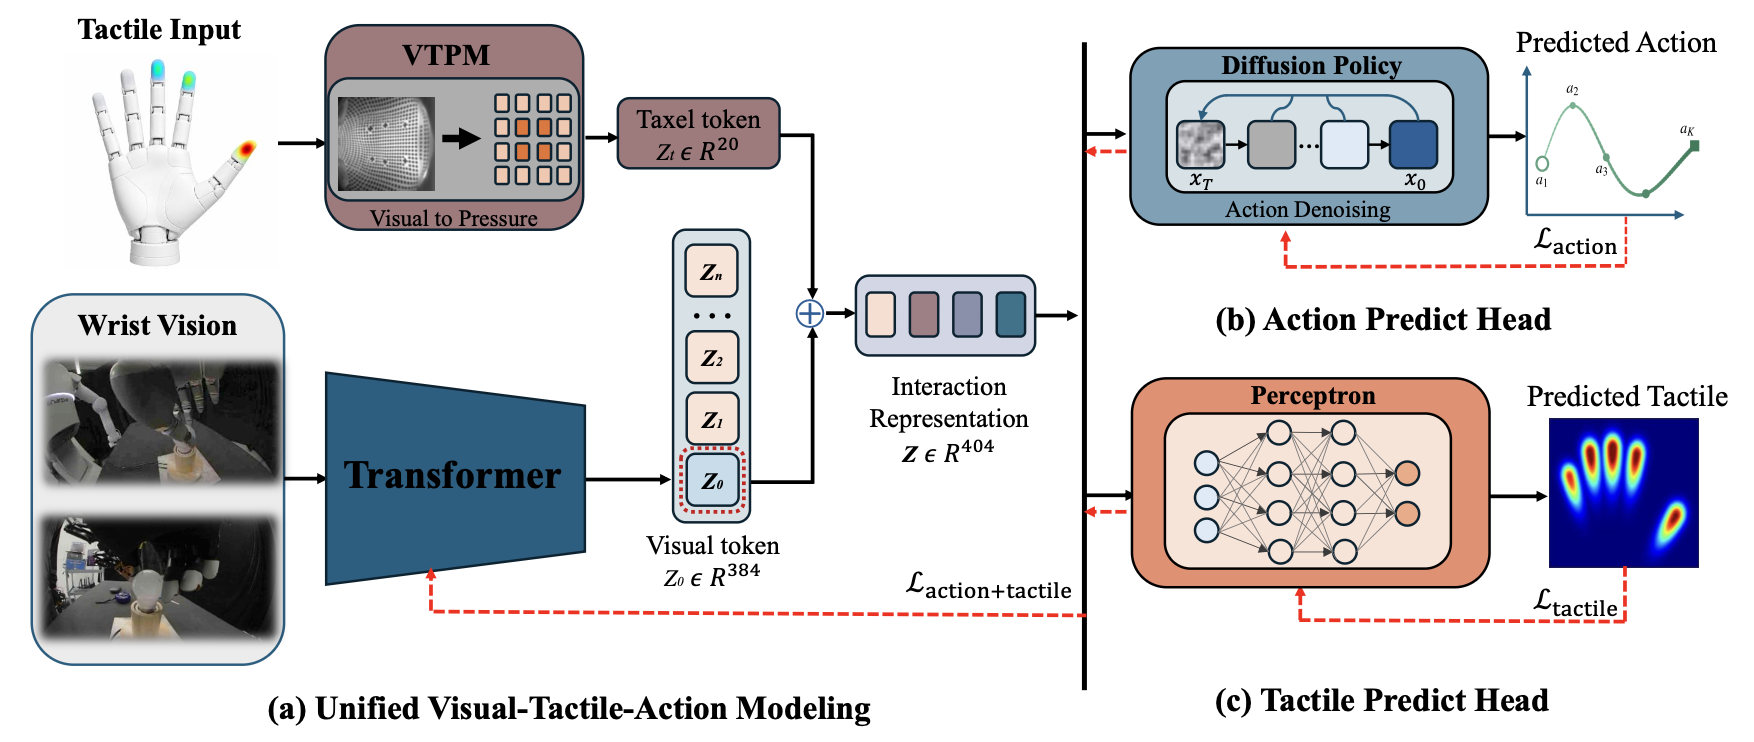 |
Wenqiao Li, Qianyou Zhao, Jiawen Hao, Xuezhou Zhu, Tengyu Liu, Kaifeng Zhang, Chuan Wen†, Siyuan Huang† arXiv |
 |
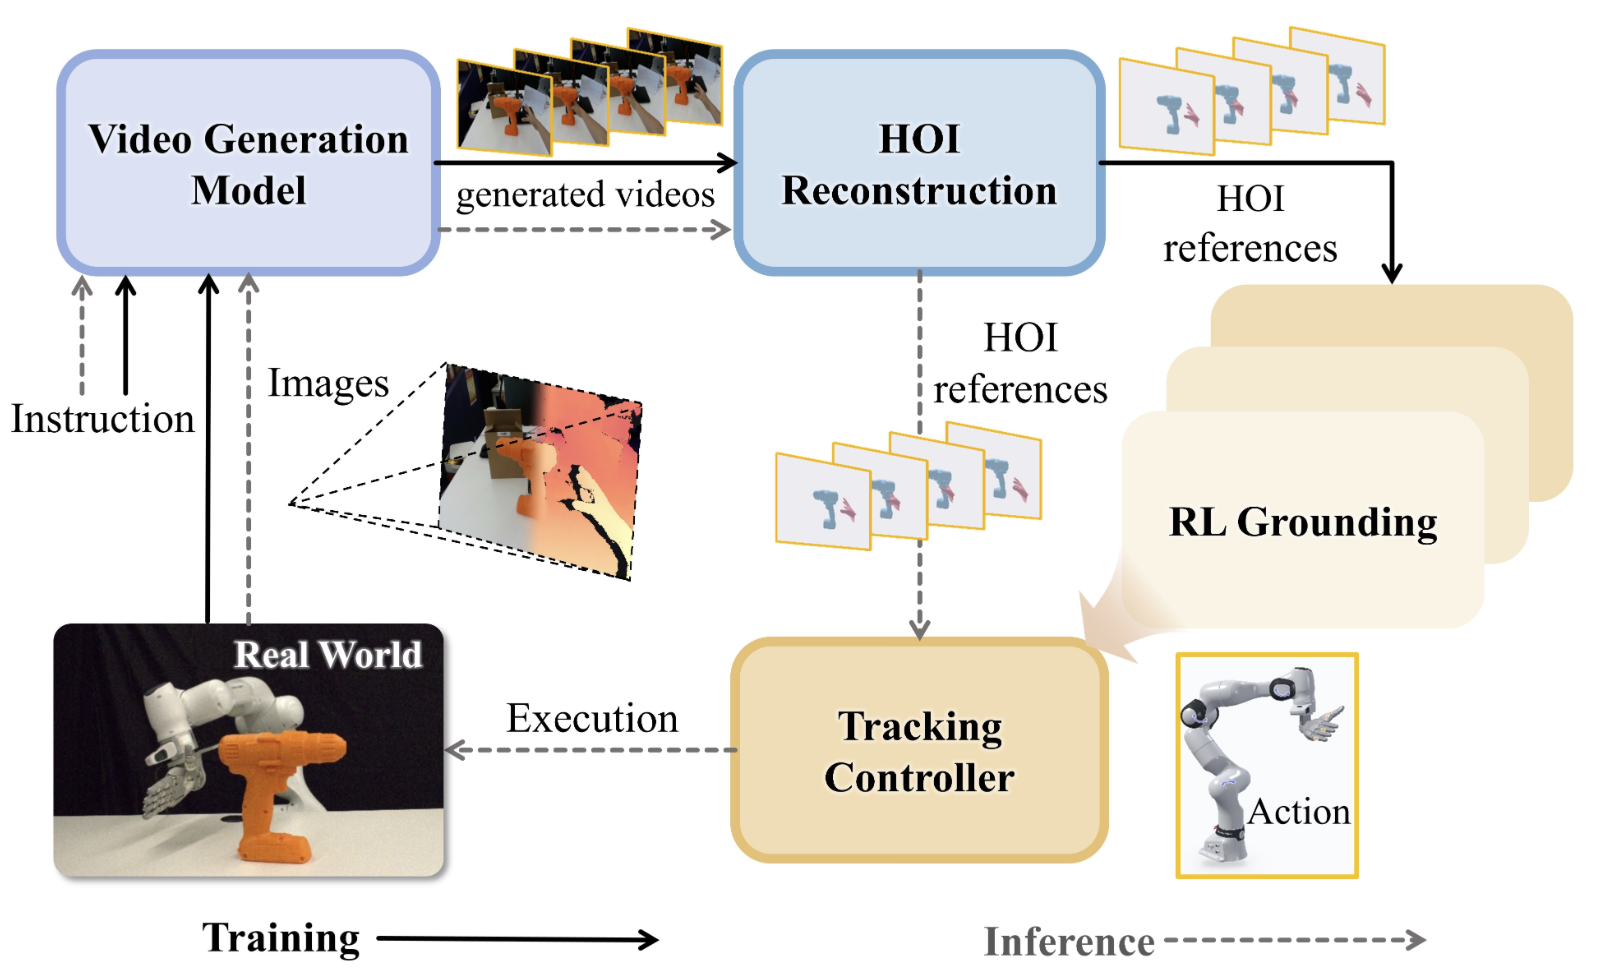
Jie Yin, Wanli Xing, Zeyuan Zhao, Xuezhou Zhu, Zhijie Deng, Kaifeng Zhang† arXiv |
 |
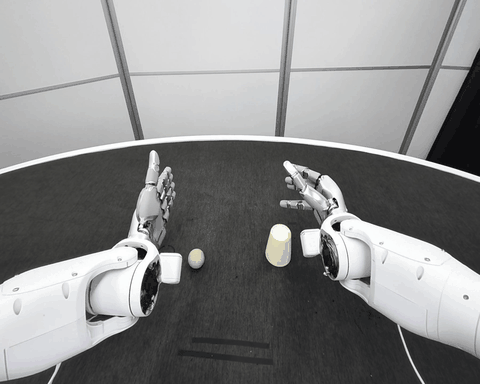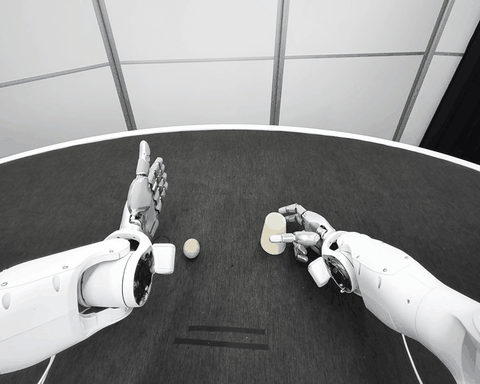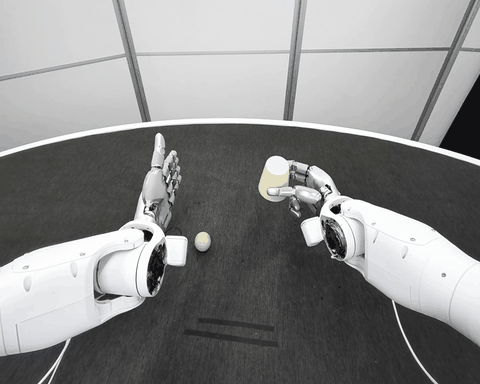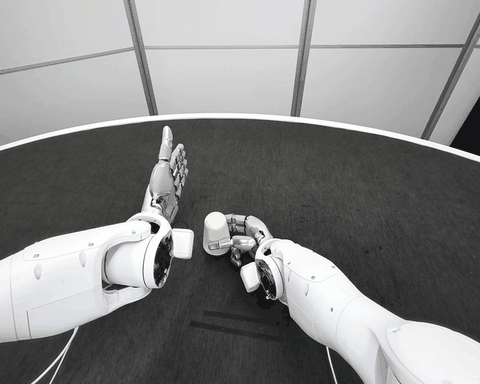
Tianyue Wu*, Boyuan An*, Shuqi Zhao, Heyu Guo, Wanli Xing, Yi Ma, Kaifeng Zhang, Ruihai Wu†, Masayoshi Tomizuka† arXiv |
|
|
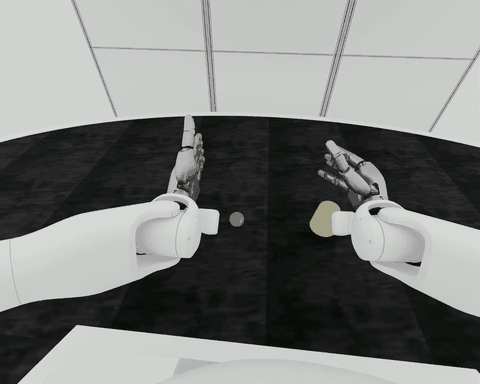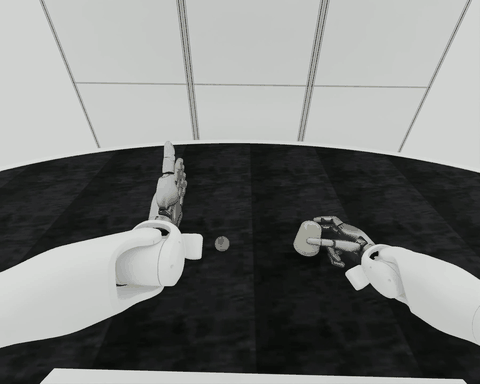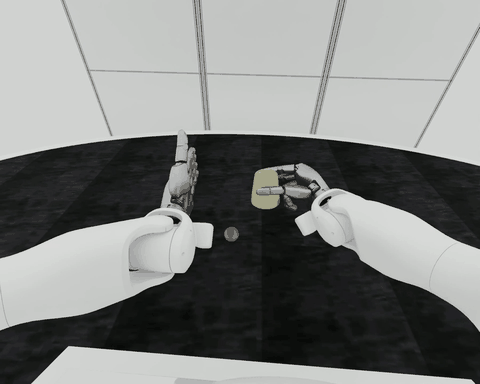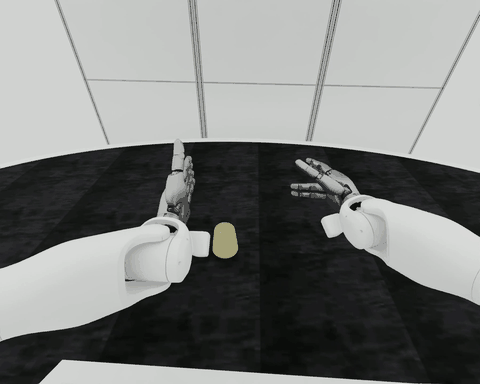
Yidi Wang*, Feixiang Ruan*, Ruoqu Chen, Jie Yin, Yang Yu, Mengdi Xu, Kaifeng Zhang† arXiv |
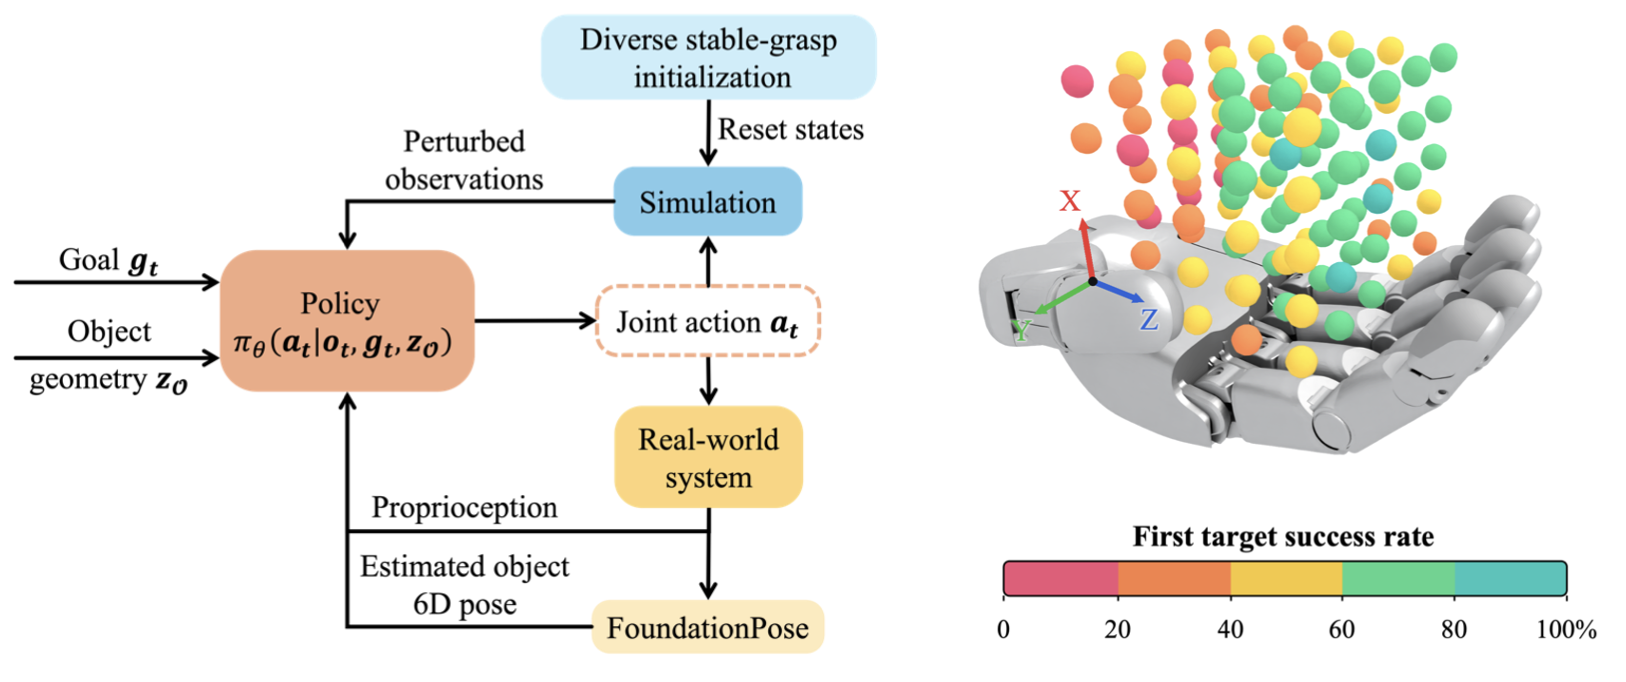 |
Junxiao Lin, Tianyue Wu, Jie Yin, Jia Pan, Kaifeng Zhang, Weiming Zhi arXiv |
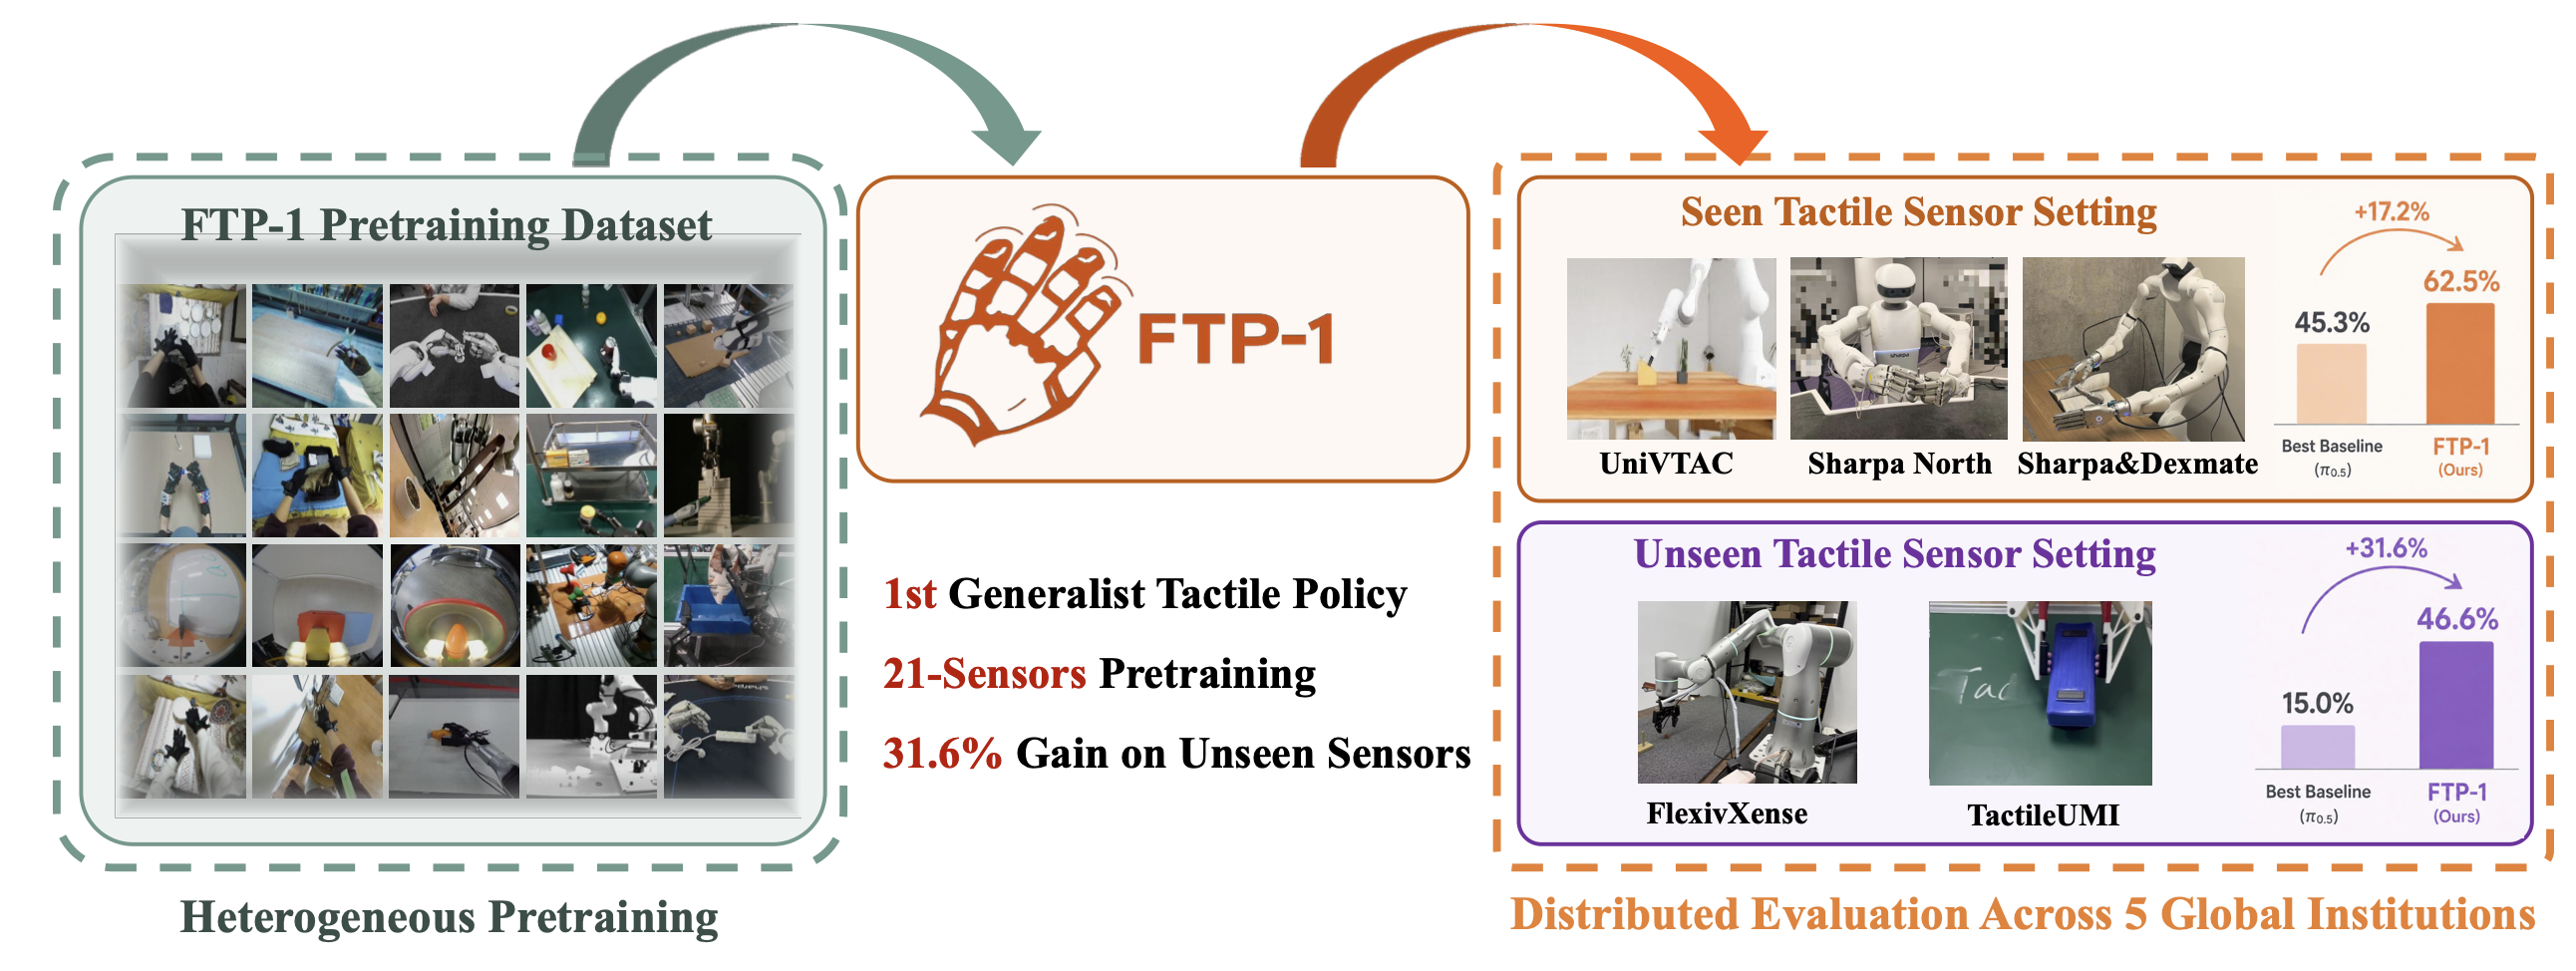 |
Chengbo Yuan*, Zicheng Zhang*, Mingjie Zhou*, Wendi Chen, Yi Wang, Zhuoyang Liu, Dantong Niu, Shuo Wang, Hui Zhang, Wenkang Zhang, Yingdong Hu, Yuanqing Gong, Wanli Xing, Chuan Wen, Cewu Lu, Kaifeng Zhang†, Yang Gao† CoRL, 2026 arXiv |
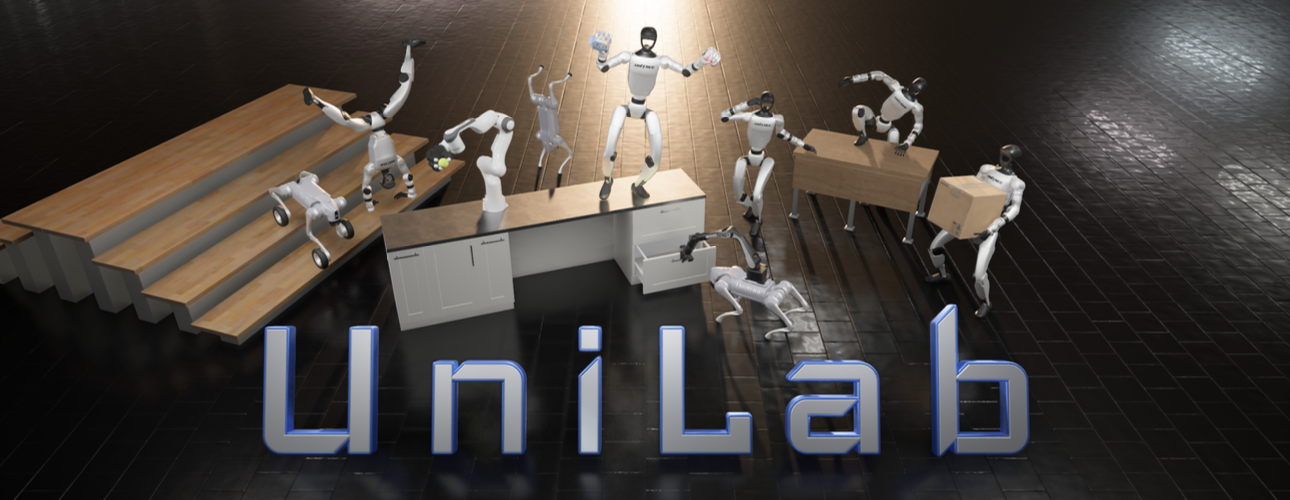 |
UniLab Team CoRL, 2026 arXiv |
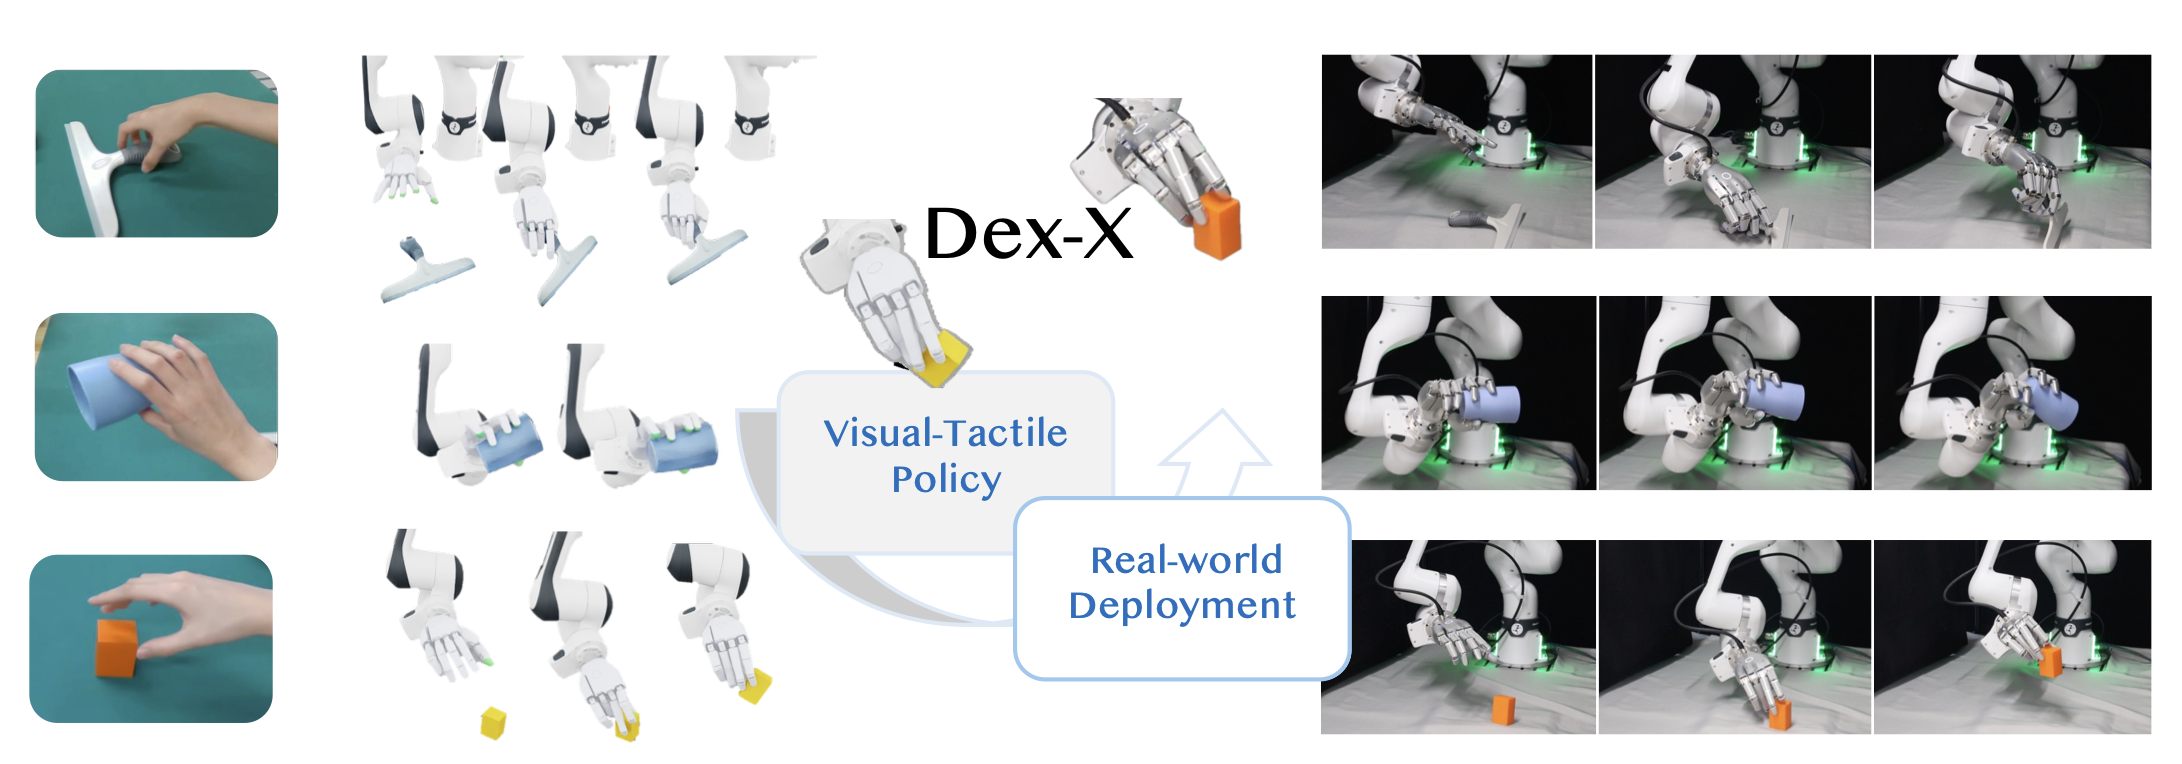 |
Ruoqu Chen, Feixiang Ruan, Liu Cao, Zihao Wang, Botian Xu, Shiqin Tong, Jiajun Liu, Wanli Xing, Kaifeng Zhang, Mengdi Xu CoRL, 2026 arXiv |
|
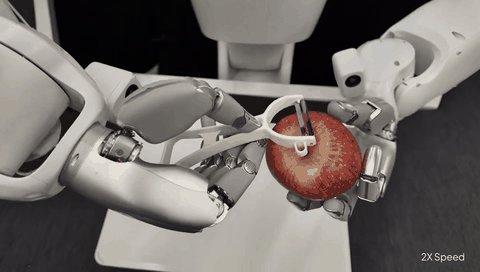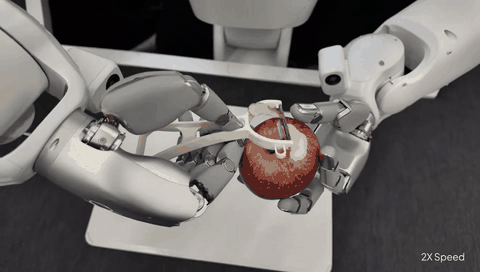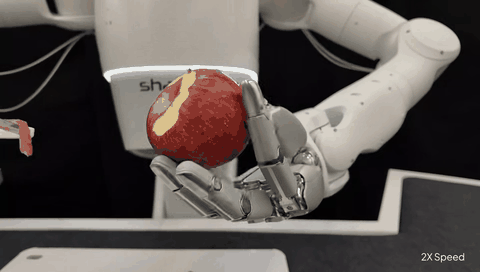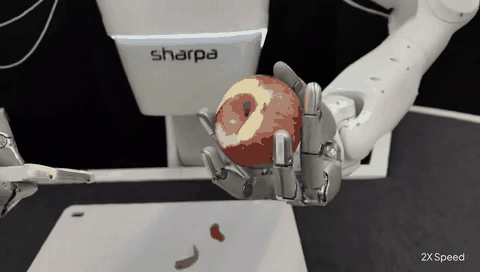
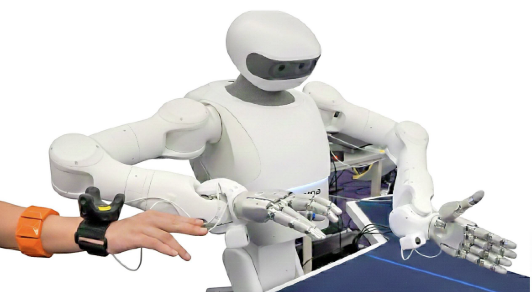
Tutian Tang*, Xingyu Ji*, Wanli Xing*, Ce Hao, Wenqiang Xu, Lin Shao, Jiangmiao Pang, Cewu Lu, Qiaojun Yu†, Kaifeng Zhang† IROS, 2026 arXiv |
|
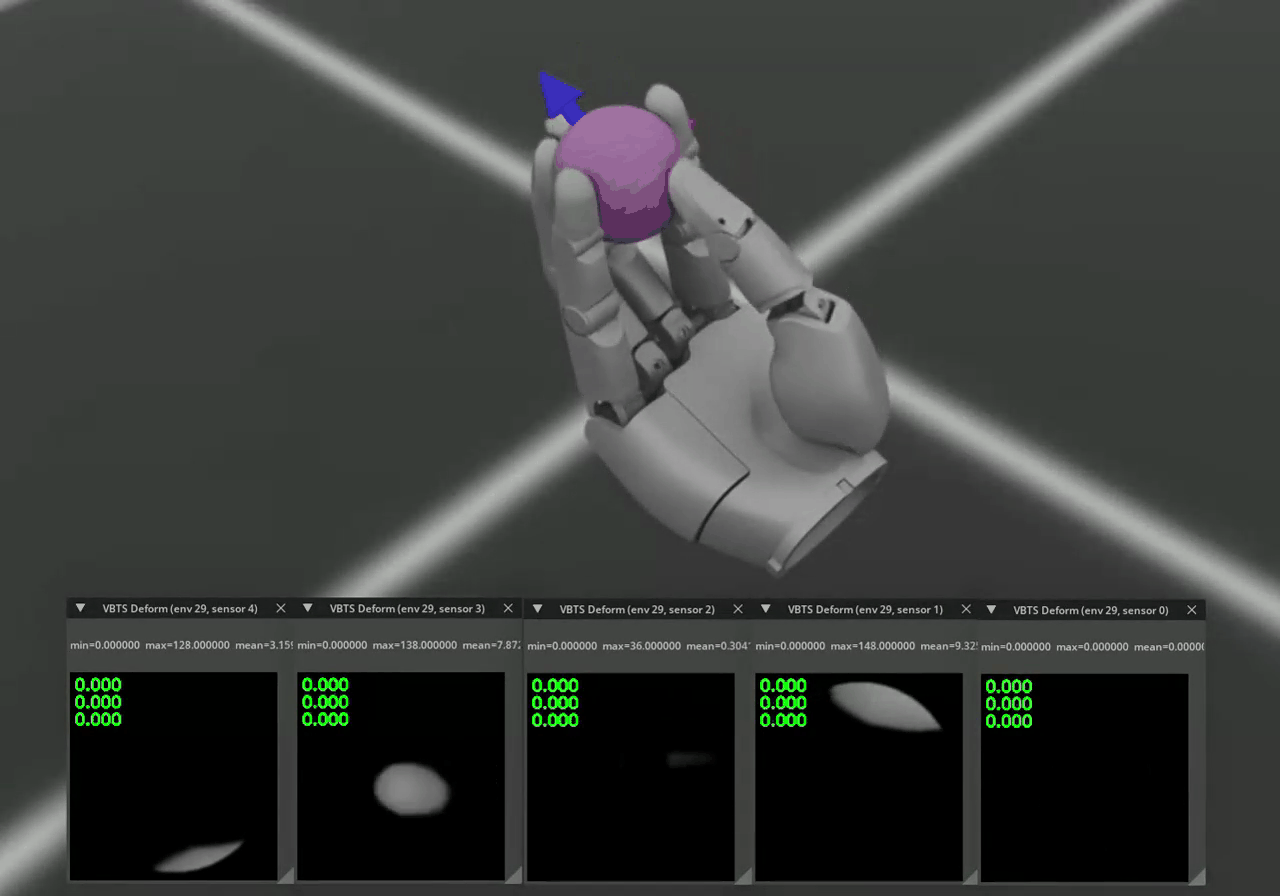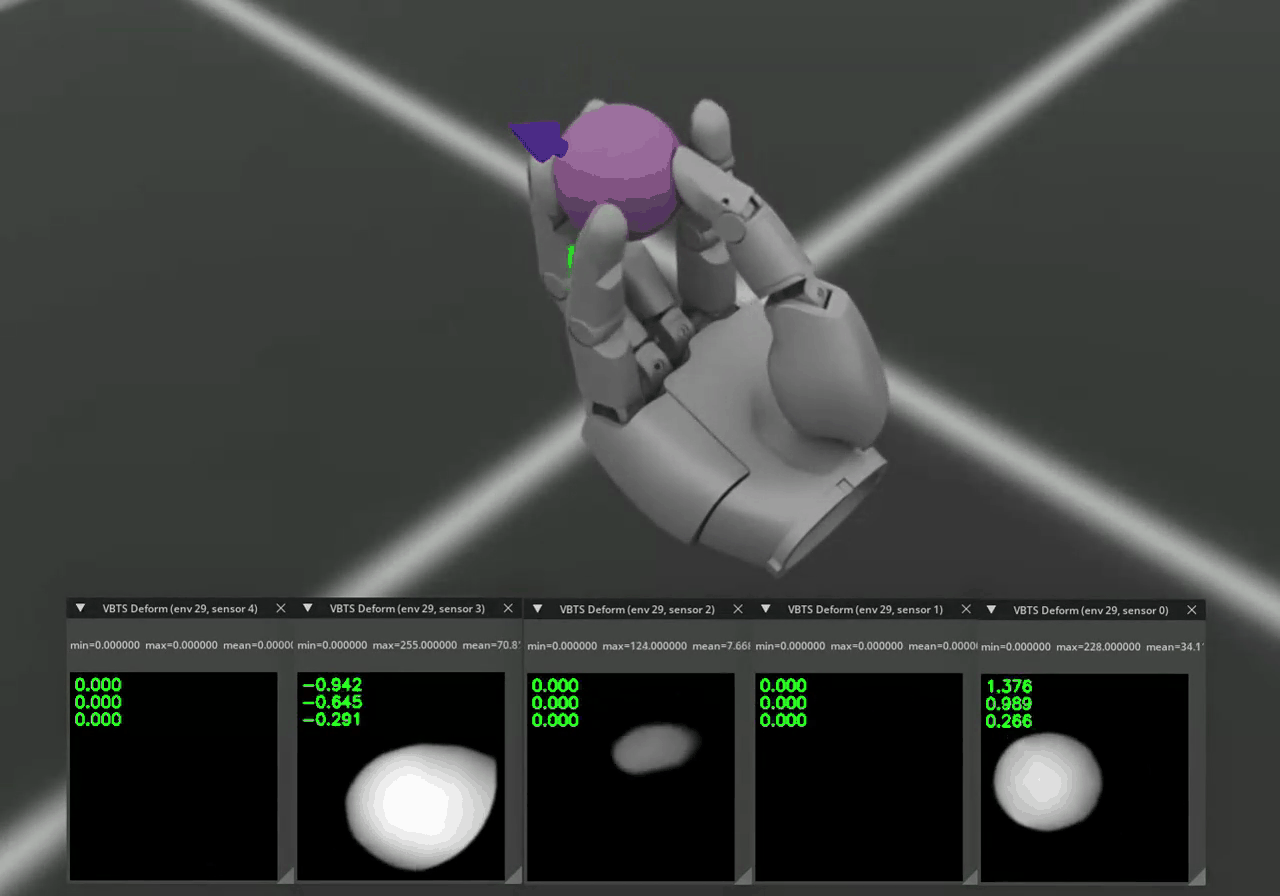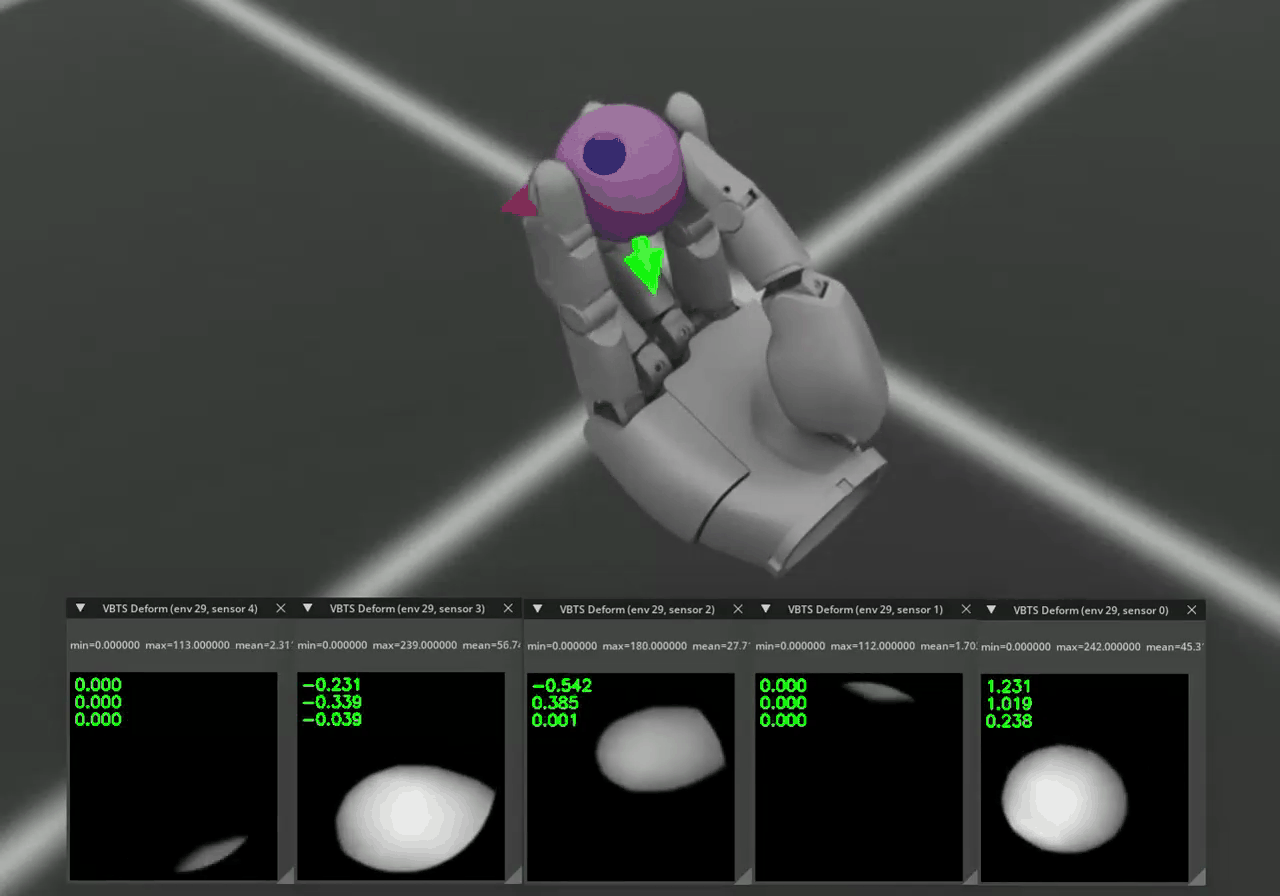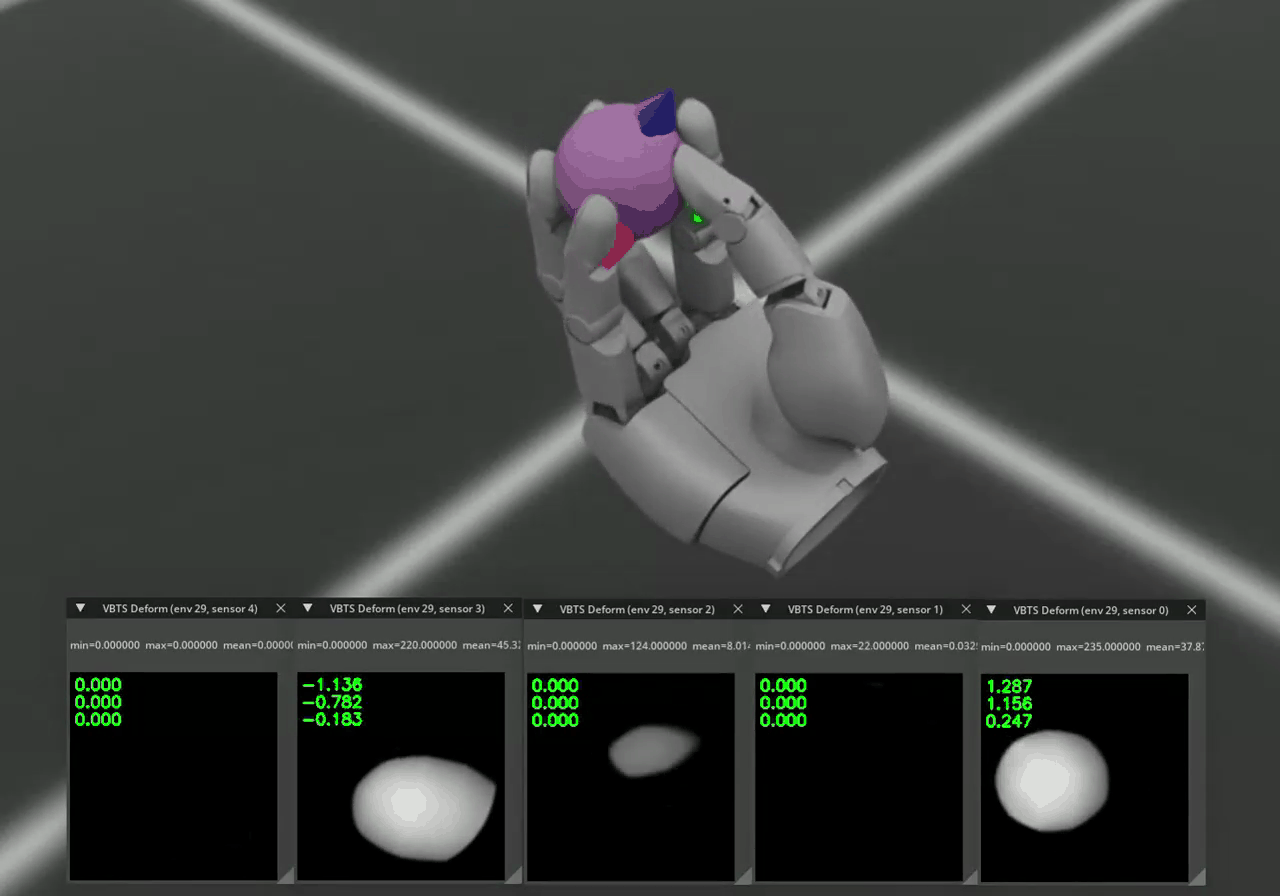
Qianyou Zhao, Wenqiao Li, Chiyu Wang, Kaifeng Zhang† IROS, 2026 arXiv |
|
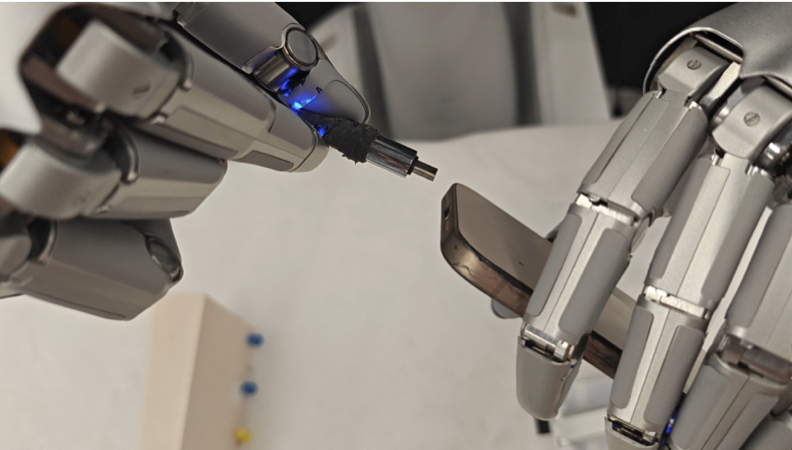
Lei Su*, Zhijie Peng*, Renyuan Ren, Shengping Mao, Juan Du, Kaifeng Zhang, Xuezhou Zhu arXiv |
|
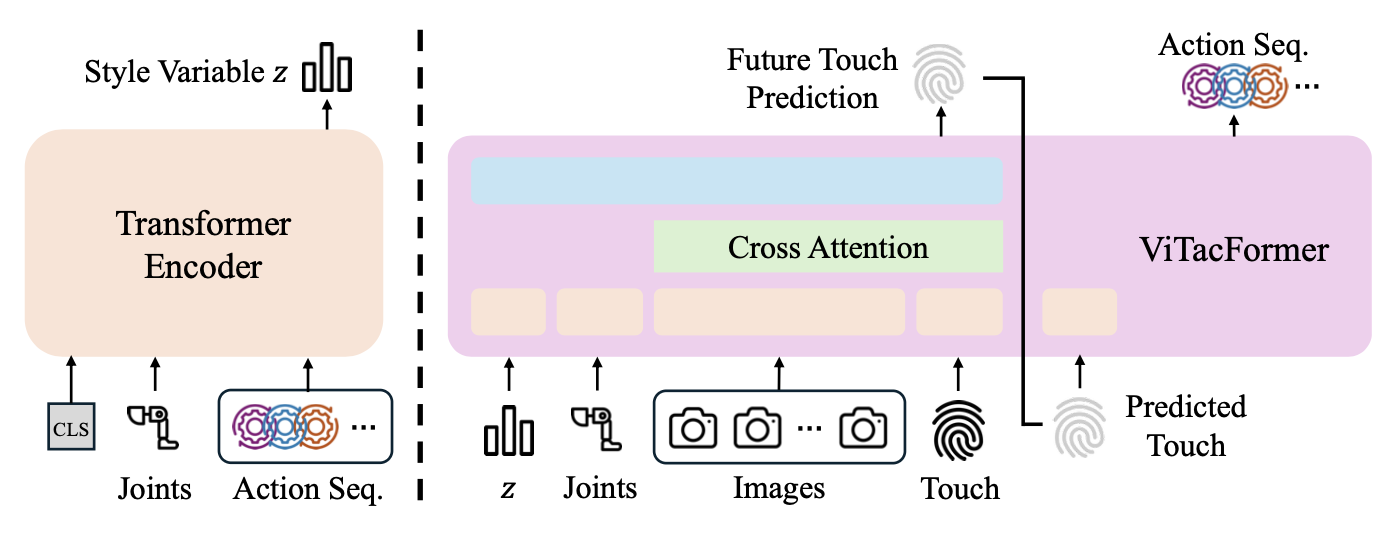
Jialei Huang*, Yang Ye*, Yuanqing Gong, Xuezhou Zhu, Yang Gao†, Kaifeng Zhang† ICRA, 2026 Oral arXiv |
|
Liang Heng*, Haoran Geng*, Kaifeng Zhang, Pieter Abbeel, Jitendra Malik RSS, 2026 arXiv |
|
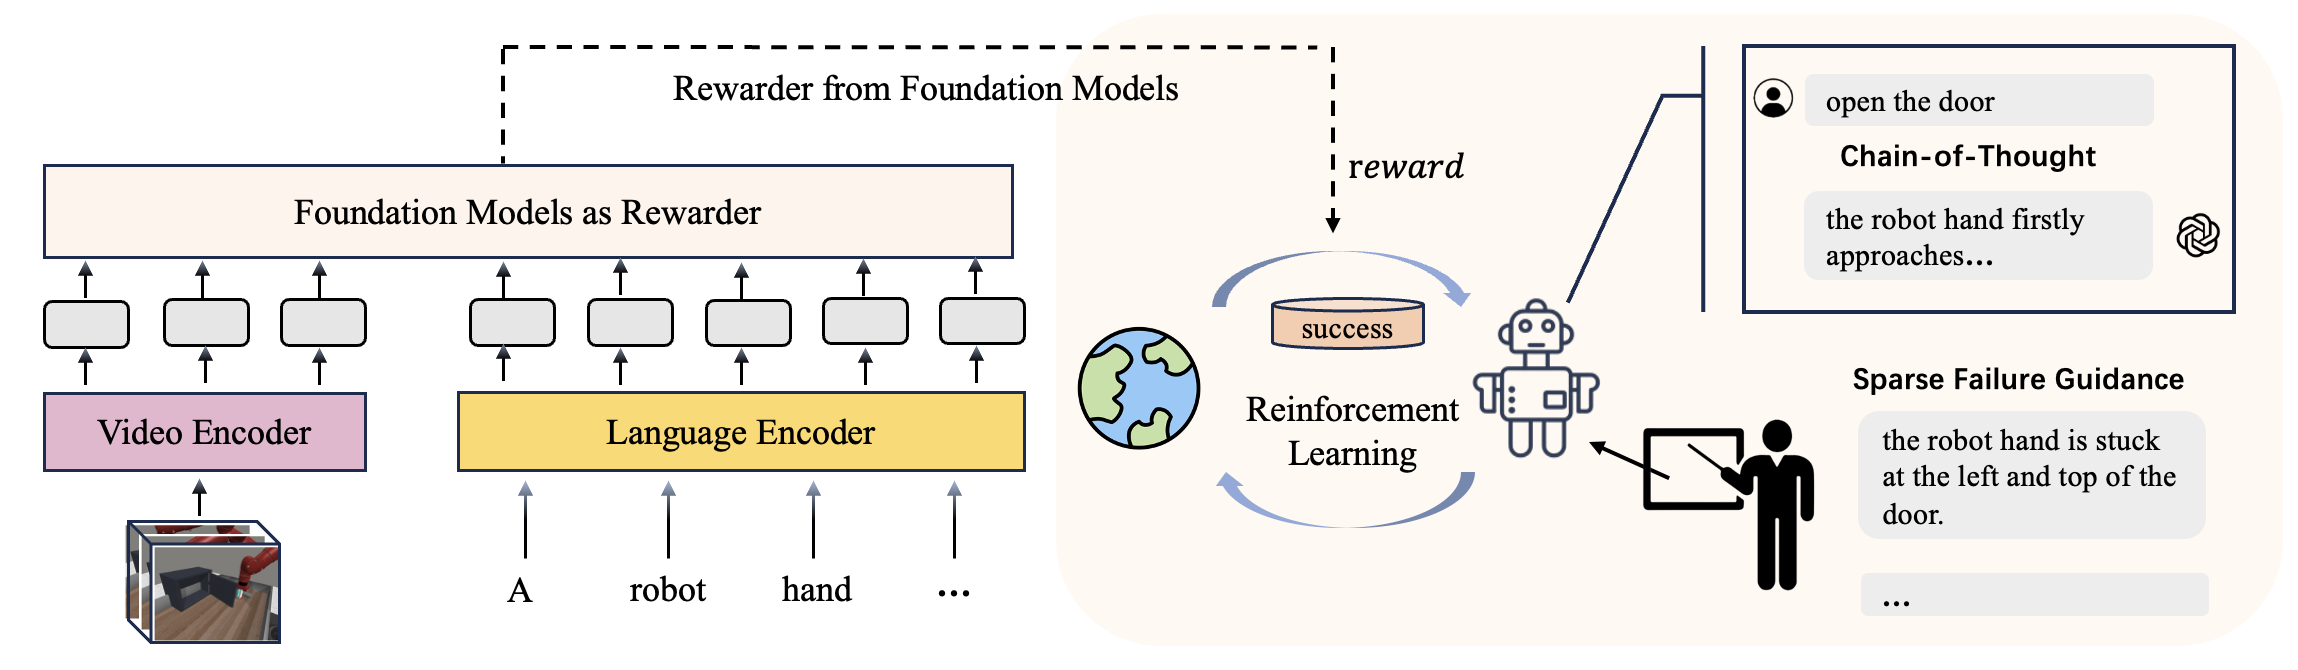
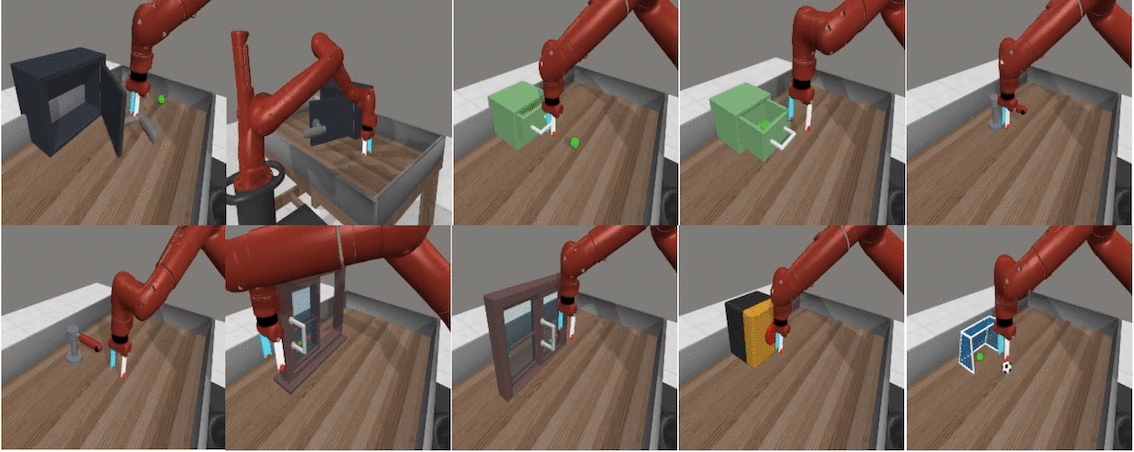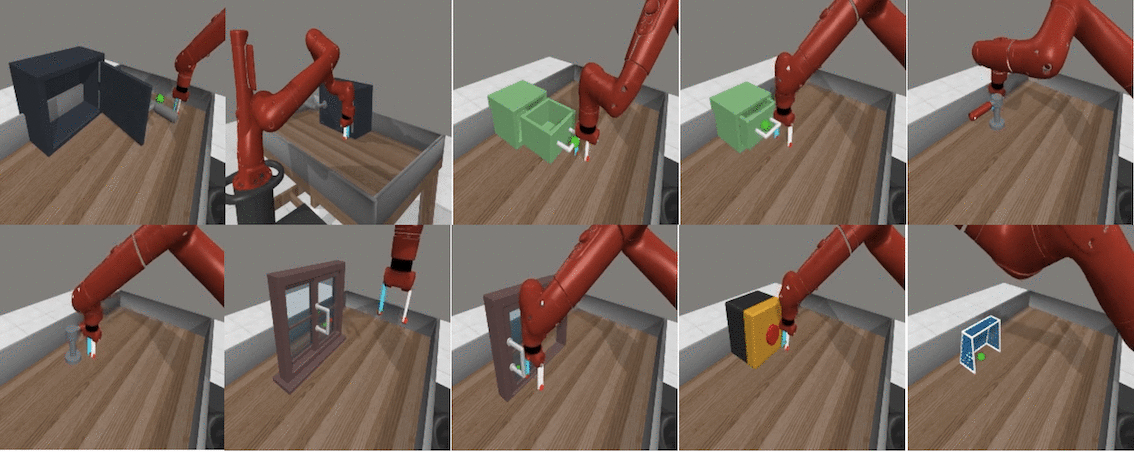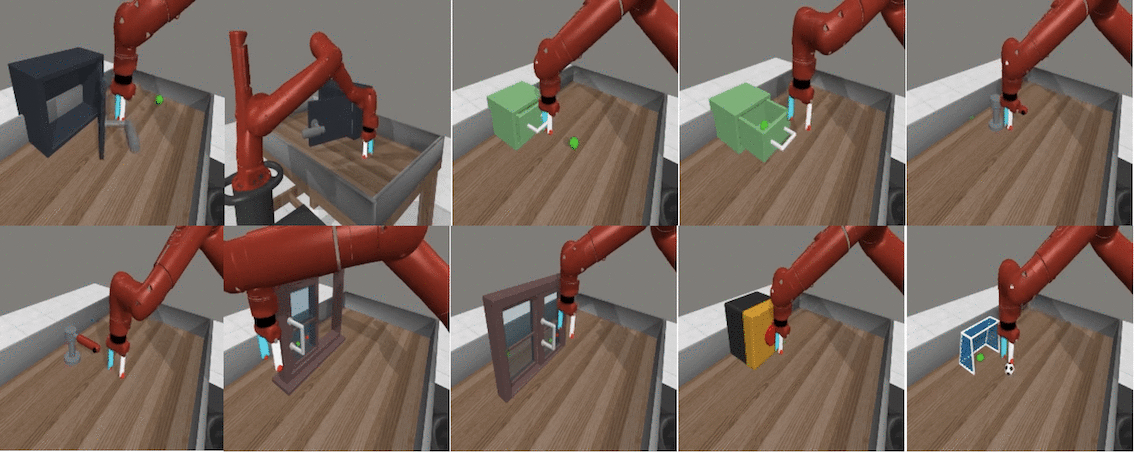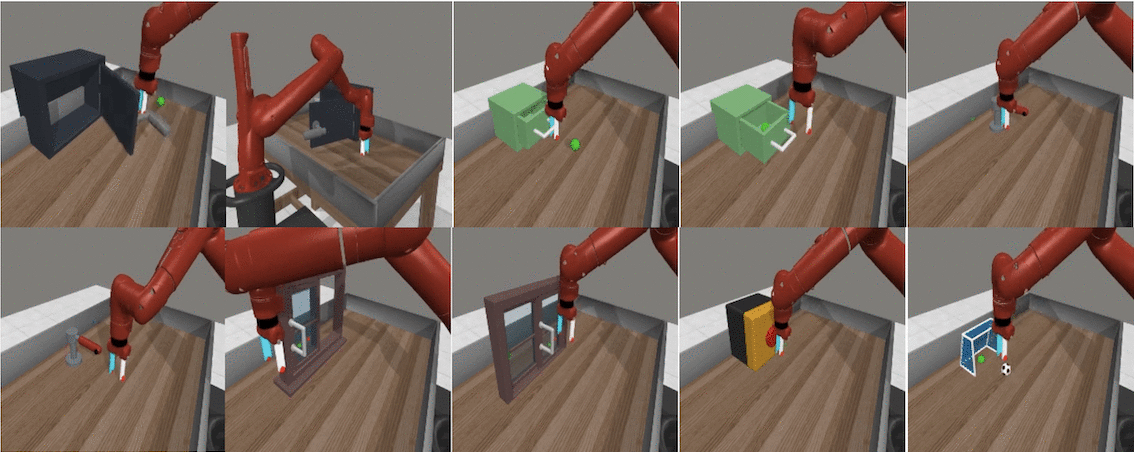
Kaifeng Zhang, Zhao-Heng Yin, Weirui Ye, Yang Gao IROS, 2025 arXiv / code Summary: (1) We propose that vision-language models can provide a superior source of rewards for agents.. (2) Our algorithm achieves a 5.4x higher average success rate compared to the best baseline, RoboCLIP. |
|
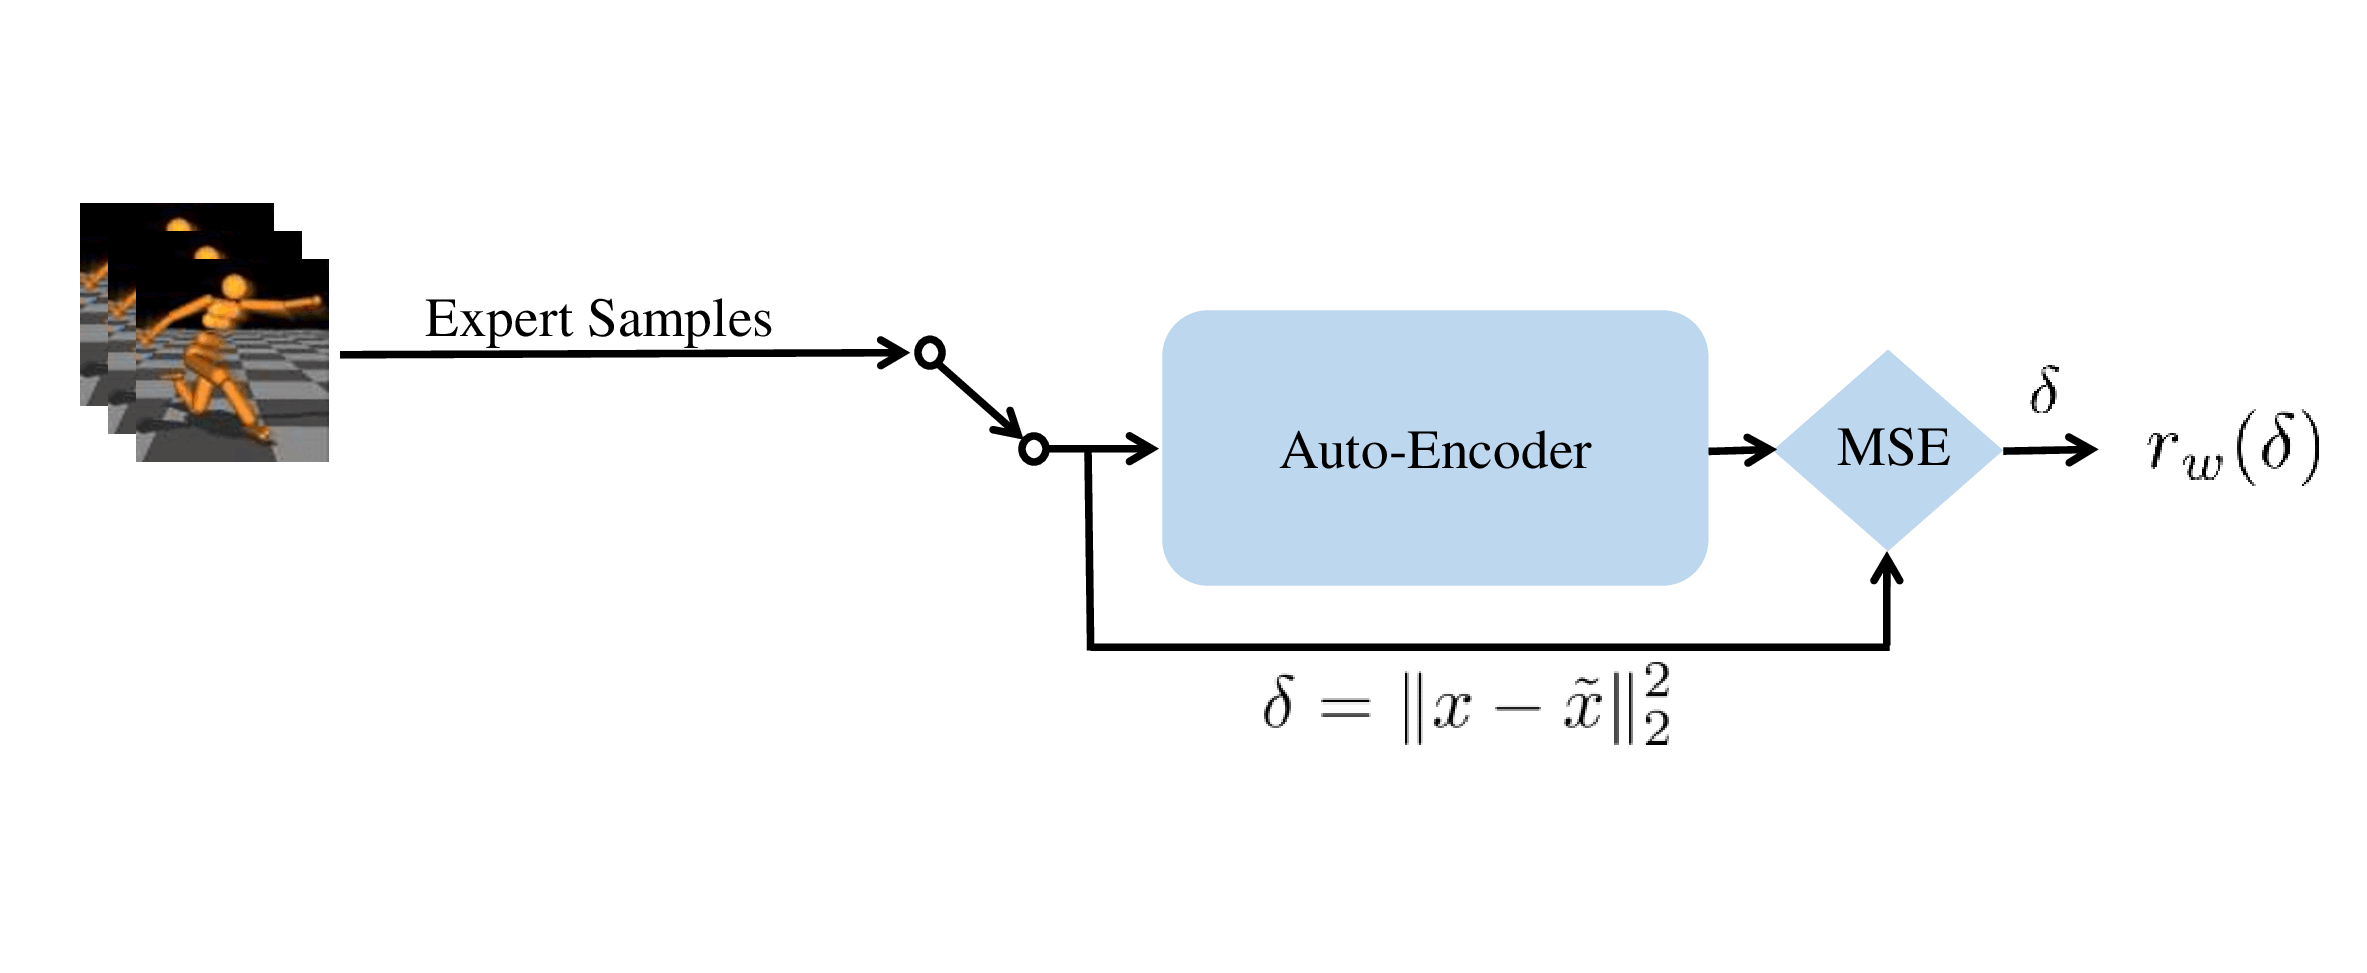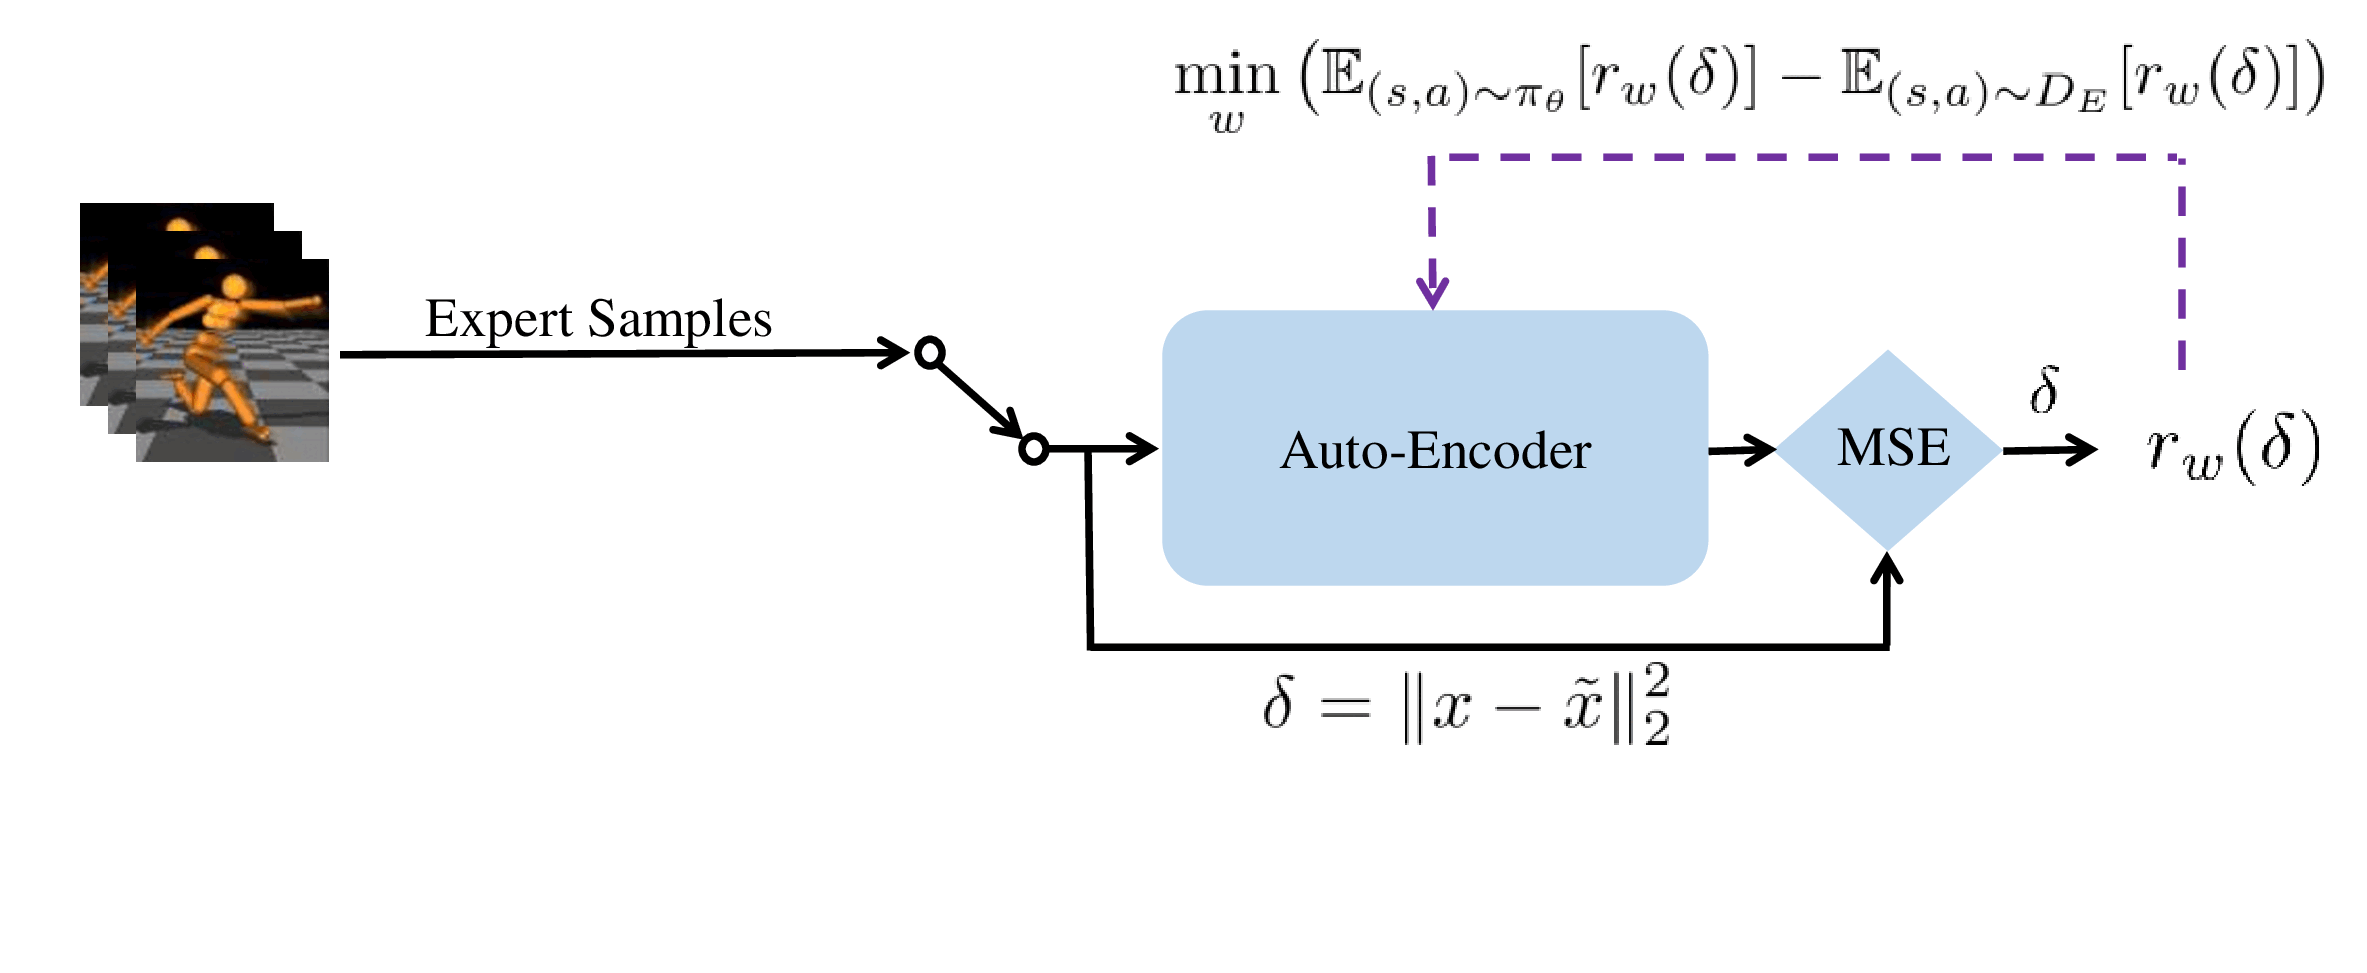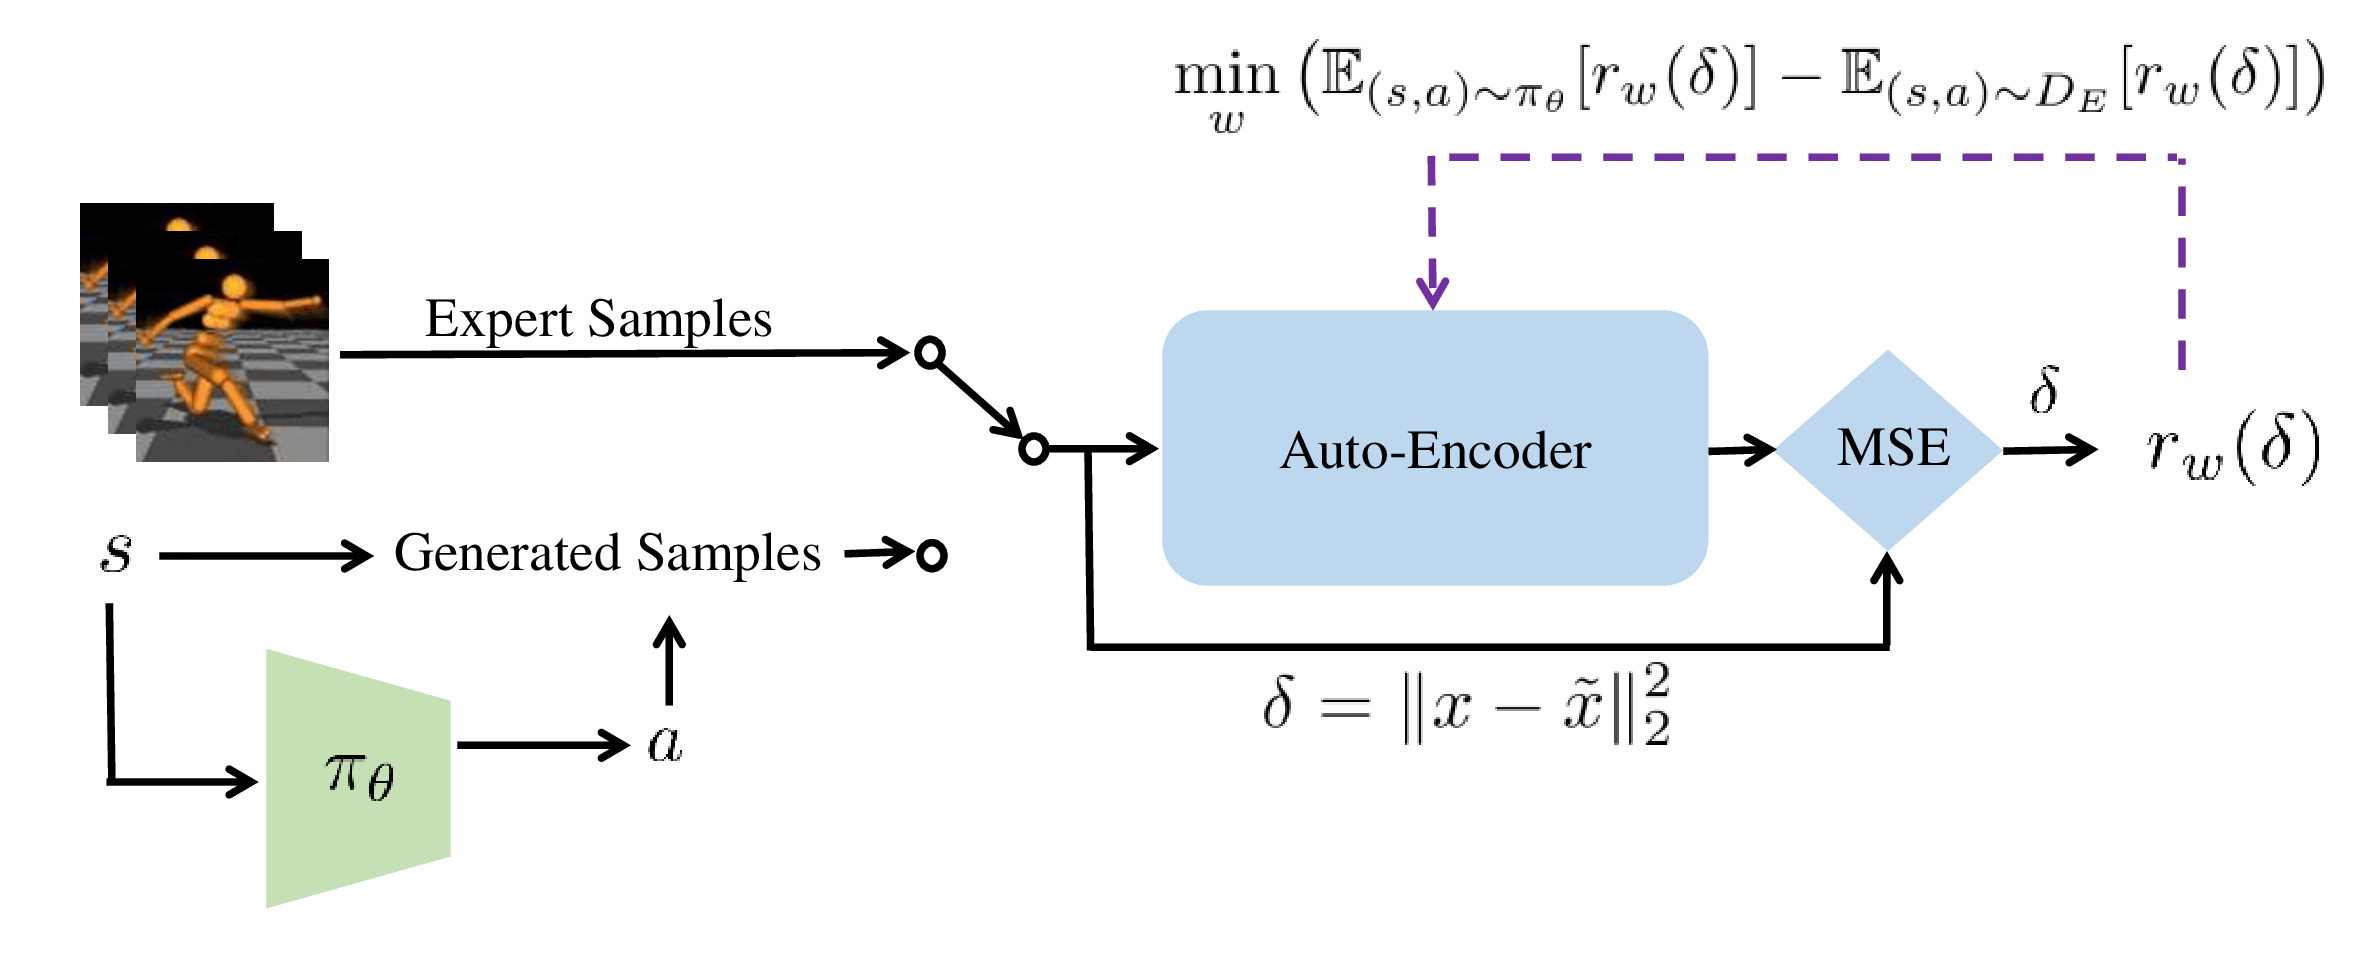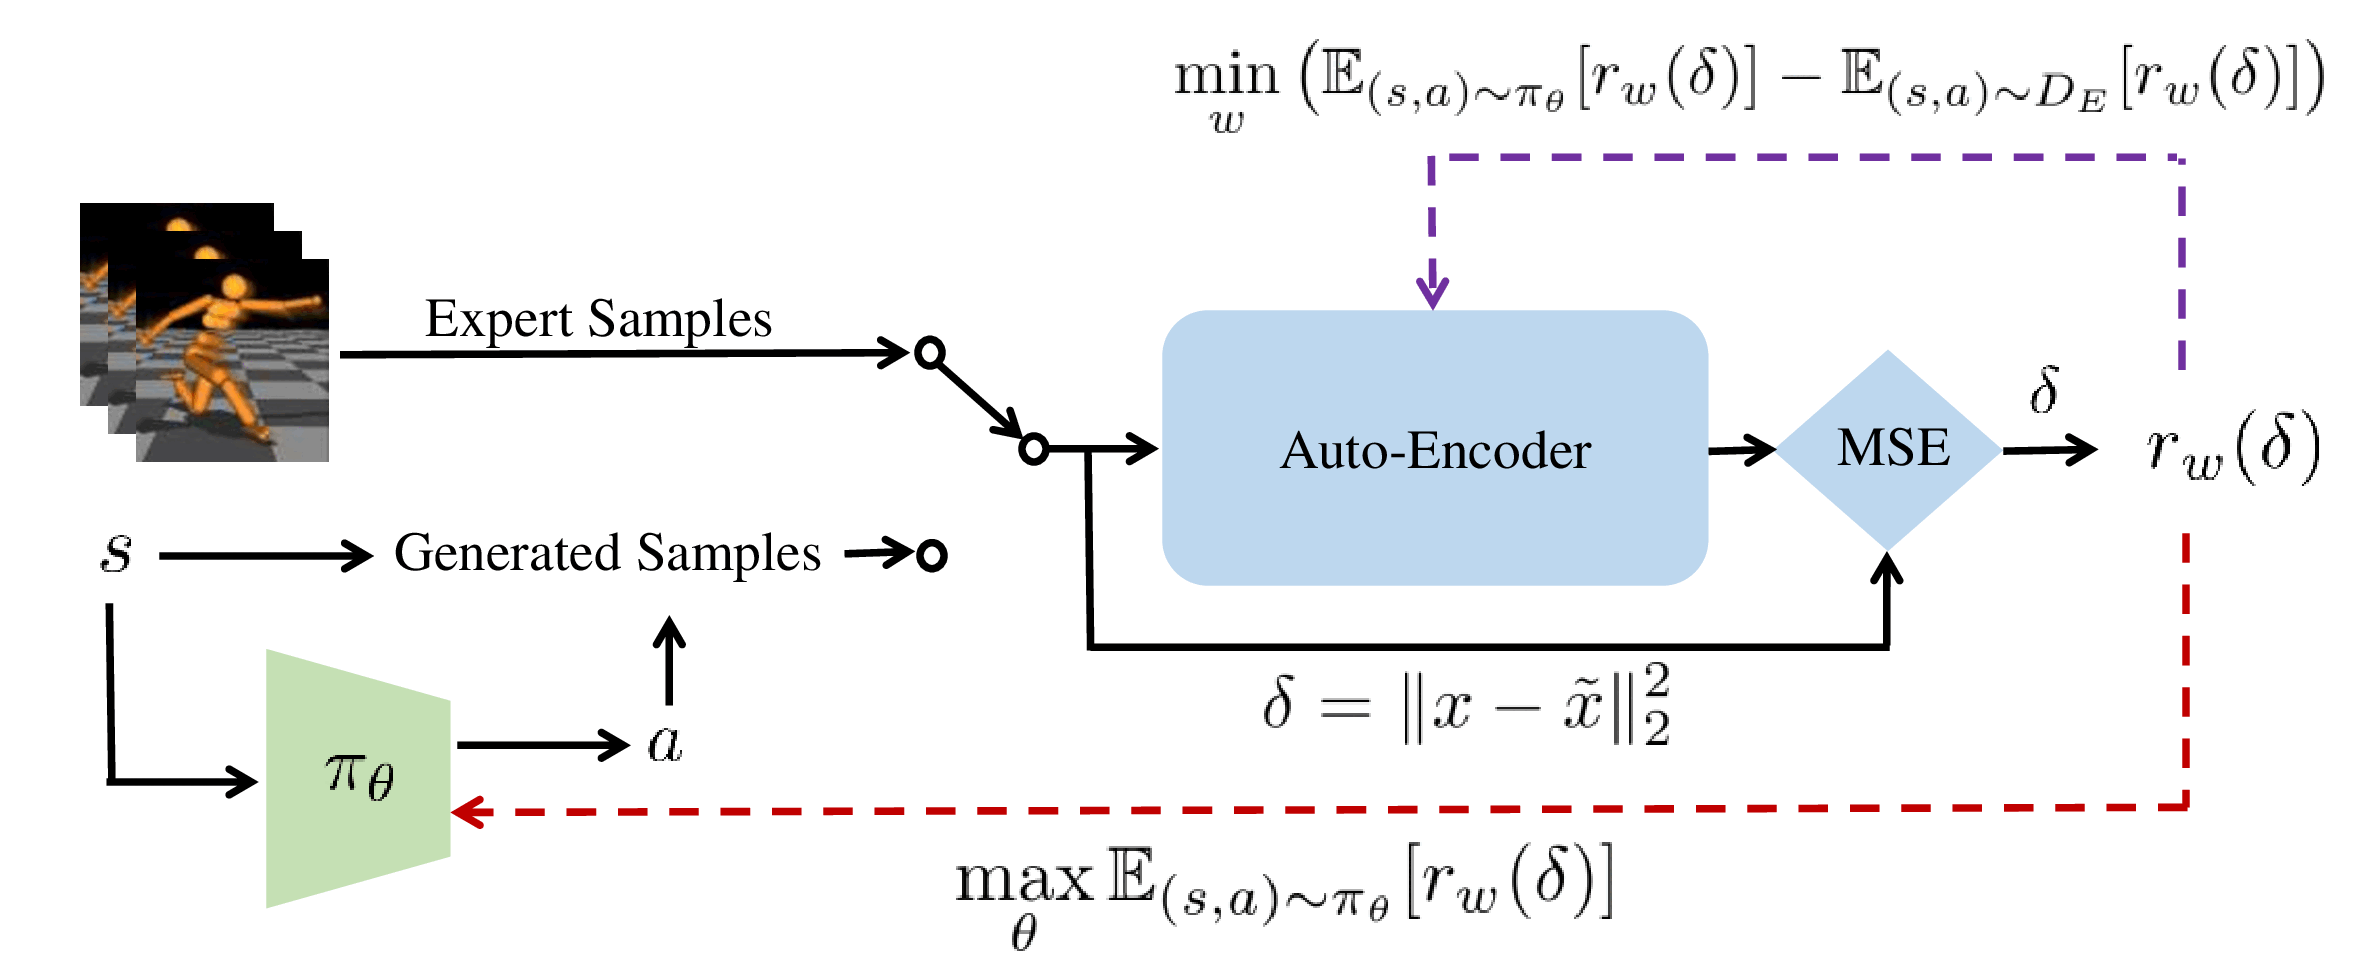
Kaifeng Zhang, Rui Zhao, Ziming Zhang, Yang Gao AAMAS, 2024 arXiv / code Summary: (1) To the best of our knowledge, we propose the first formulation of auto-encoder based reward signal for adversarial imitation learning. (2) Our auto-encoding AIL provides a denser reward signal to the agent policy. |
|
心外无物 莫向外求 |